
LLM-Aided OCR
LLM-Aided OCR извлекает текст из PDF и исправляет ошибки распознавания, помогая разработчикам обрабатывать сканированные документы.
Бесплатный тариф Есть бесплатный тариф Русского языка нет Open-source
Перейти на сайт Проверено 15 октября 2026
Что это
LLM-Aided OCR преобразует страницы PDF в изображения, извлекает из них текст с помощью Tesseract и корректирует ошибки. По желанию результат оформляется в Markdown; доступны удаление повторов и оценка качества. Можно также обрабатывать уже распознанный текст или запускать очистку без языковой модели.
Инструмент рассчитан на разработчиков и тех, кому нужно работать со сканами через командную строку. Для исправления текста используются локальные языковые модели или API OpenAI и Anthropic.
Исходный код открыт, программа устанавливается и запускается локально после настройки зависимостей. Для обращения к API могут потребоваться данные учётной записи у провайдера; сведения о стоимости в материалах не указаны.
Доступность из России
| Открывается из РФ | да |
|---|---|
| Русский интерфейс | нет |
| Оплата российскими картами | не проверено |
| На чём основано | В описании репозитория есть инструкции по локальной установке и режим с локальной моделью; признаков ограничений для пользователей из России на предоставленных страницах нет. Данных об оплате российскими картами нет. |
Сколько стоит
Бесплатно: 2,000 CI/CD minutes/month; 500MB of Packages storage
| Тариф | Цена | Период |
|---|---|---|
| Free | 0 USD | в месяц |
| Team | 4 USD | в месяц |
| Enterprise | 21 USD | в месяц |
Детали
| Платформы | Можно запустить у себя |
|---|---|
| API | нет |
| Разработчик | Dicklesworthstone |
| Интеграции | Tesseract, OpenAI API, Anthropic API, llama.cpp |
| Исходный код | https://github.com/Dicklesworthstone/llm_aided_ocr |
Задачи
Категории
Профессии
Похожие инструменты
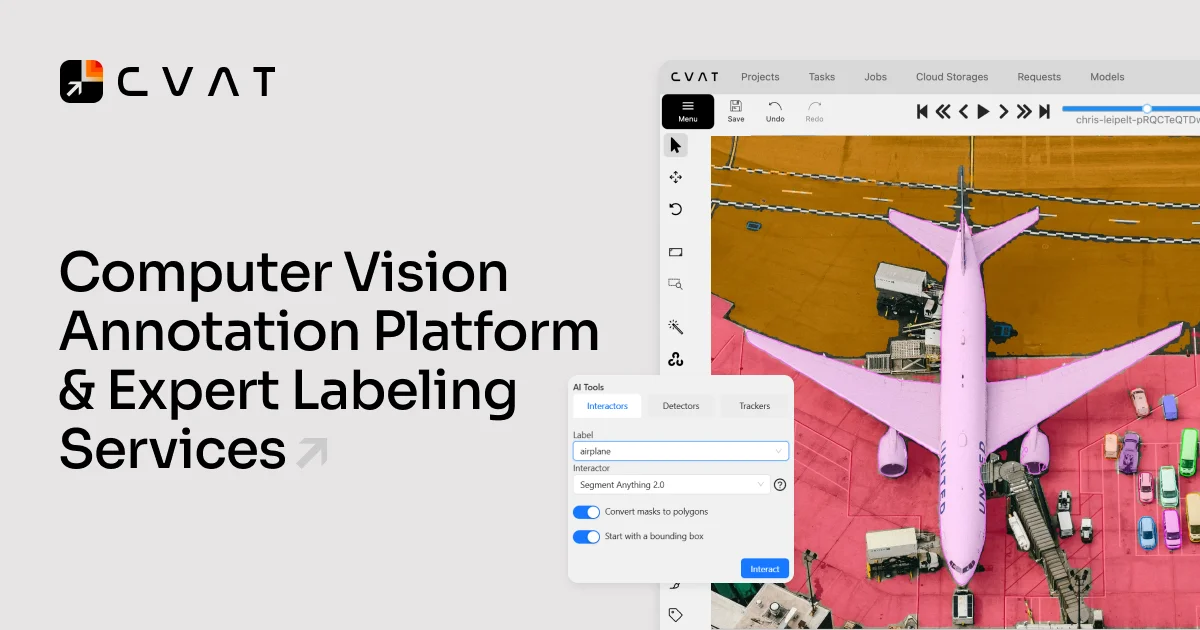 CVAT
CVAT помогает размечать изображения и видео; инструмент подходит разработчикам и исследователям в области компьютерного зрения.
Бесплатно
Русский язык
Open-source
от 23 $
 Docspell
Система для сбора и упорядочивания документов из сканеров, электронной почты и других источников.
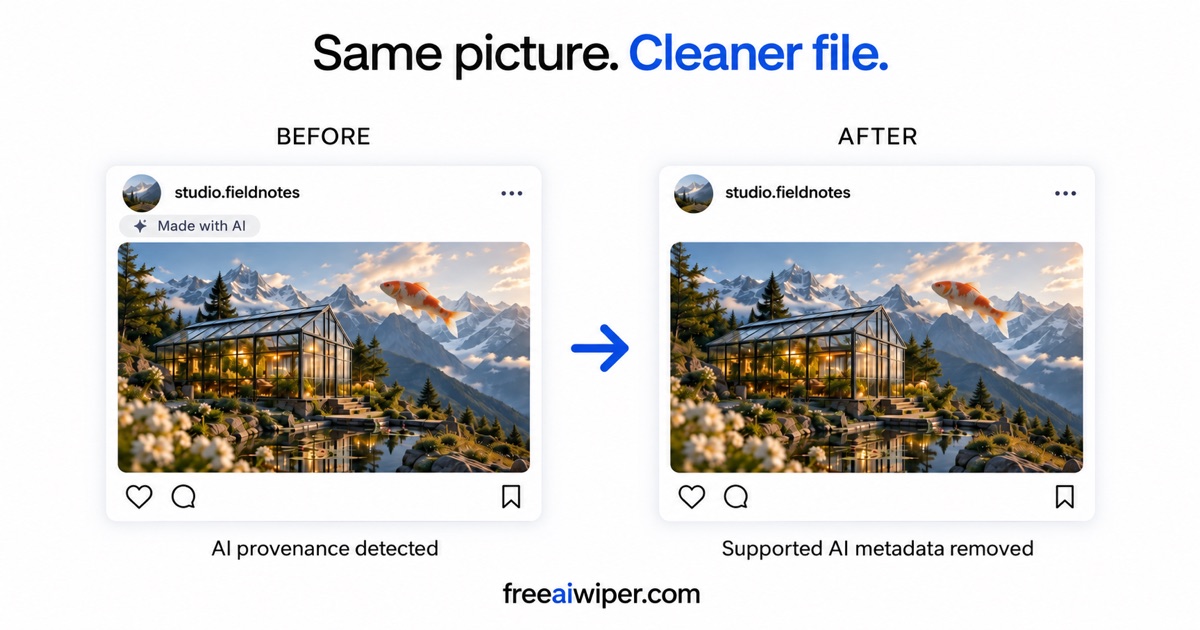 Free AI Wiper
 проверяет и удаляет поддерживаемые метаданные файлов для тех, кто хочет очистить изображения, документы и другие материалы.
Бесплатно